www.itmedia.co.jp
画像を入力として、それを作成するお絵描きタイムラプスのような動画を生成するAIが公開されたというニュースを見た。名前をPaints-UNDOという。
サンプルページの生成サンプルをみて、「すごい!」と「まだ変なところがあるな…」と思った。
で、どんなもんかと実際に触ってみることにした。
サンプルページには
Note that all input images in this webpage are AI-generated (except that Rickroll). Their "ground truth" drawing processes do not exist.
https://lllyasviel.github.io/pages/paints_undo/
と書いてあるが、うるせえテメーのground truthと比較せんかい💢という気持ちになった。
こっちにはground truthがあるんだぞ…😕
動作方法はこのあたりを参考に
- 描画工程を推論する「Paints-Undo」、Google Colabで実際に動作させてみた|AICU media
- GitHub - lllyasviel/Paints-UNDO: Understand Human Behavior to Align True Needs
ちなみにNvidia RTX3060 12GBで動作した。PCのRAMは32GBあれば動きそうな気がする(このマシンは64GBだけれど)。
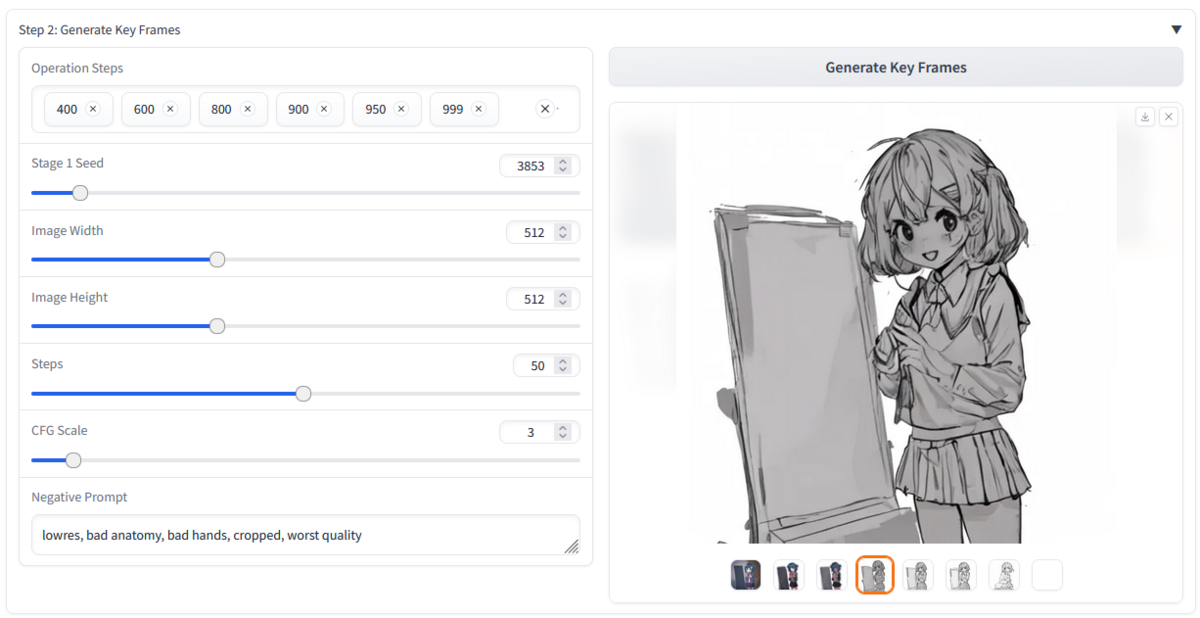
結果
それぞれ3つほど生成してみた。もっといいものはできるかもしれないが、特別悪いものを抜き出したわけでもない。
例1
入力画像
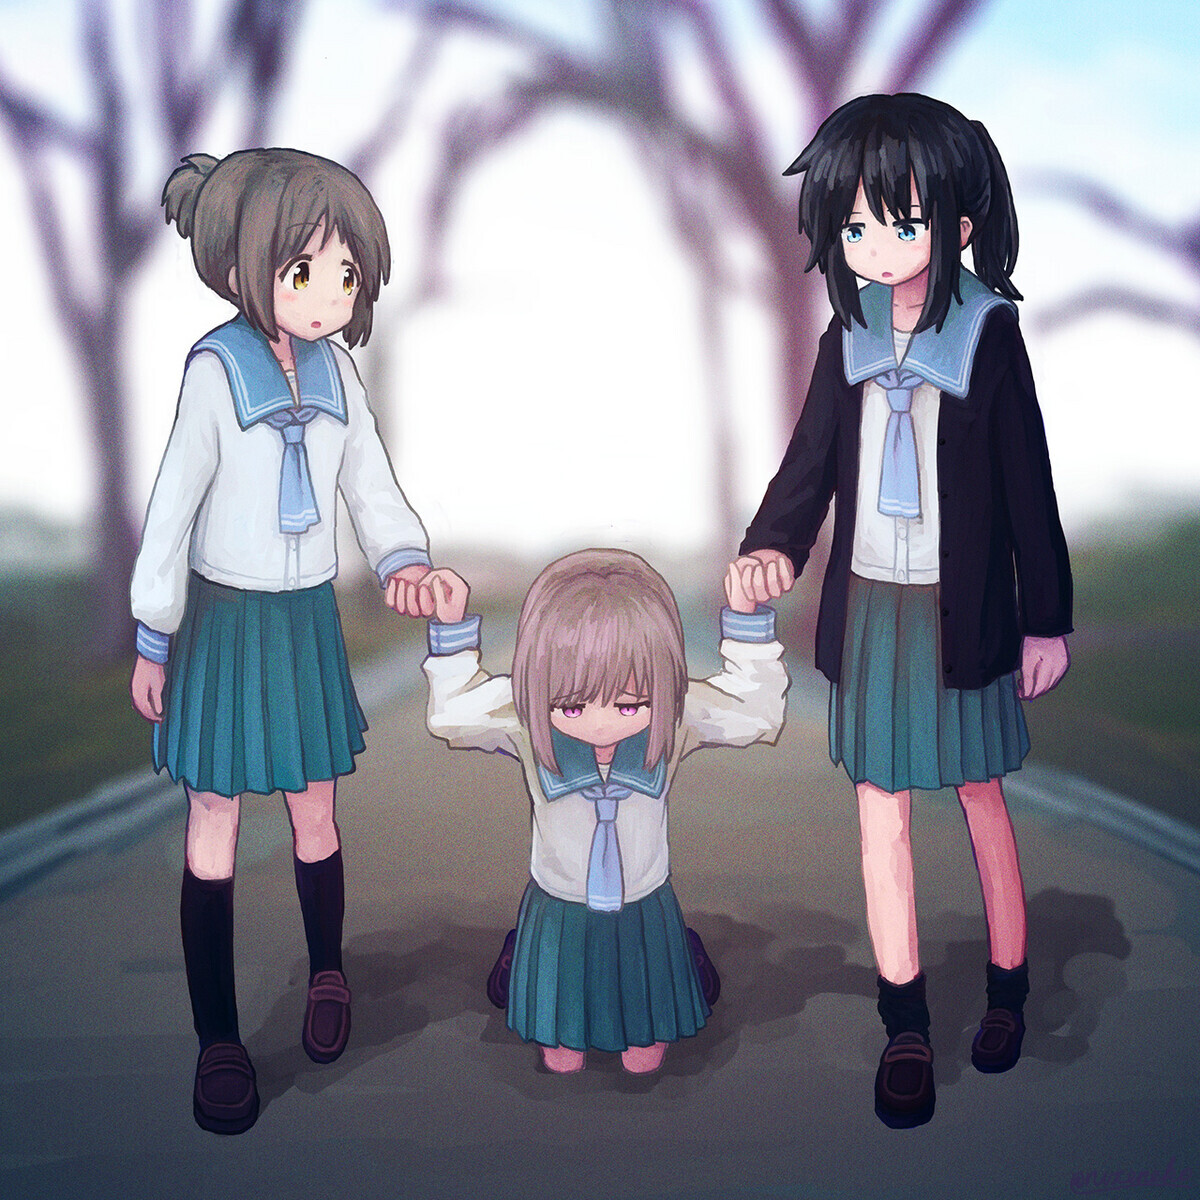
出力結果A
出力結果B
出力結果C
www.youtube.com
なんかアスペクト比変ですね。キーフレーム生成では正方形にしているので、動画(in-between)作成時にそれを参照できてないのかな。
Ground truth
例2
入力画像
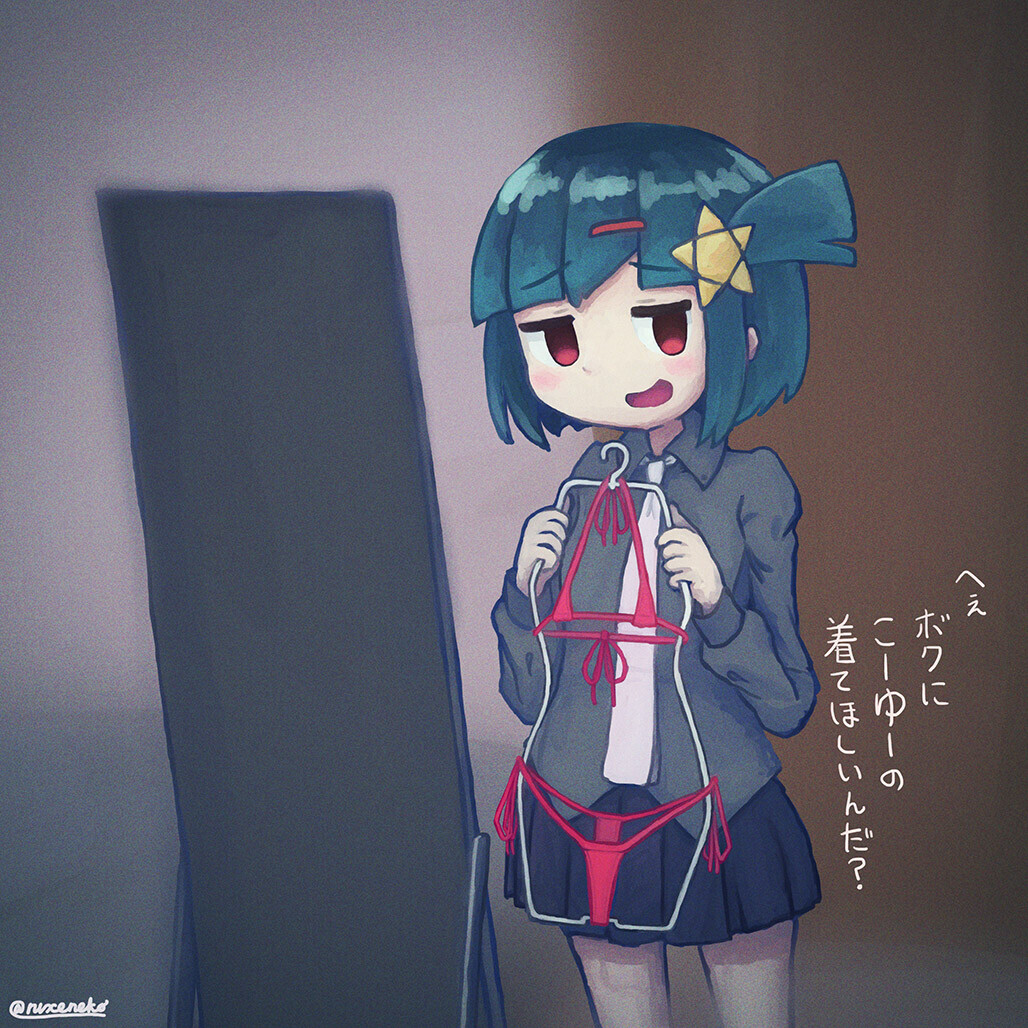
出力結果A
出力結果B
Ground truth
何やってるの
で、これ、お絵かきタイムラプス風動画を生成するのだが、全然タイムラプス動画ではない。
人間が描いたタイムラプス動画から学習してるとかではなさそうである。
どうやら、完成形の絵(=入力)の絵から白紙の画像へと近づけていく中間点での画像を生成し、それらを補間するように間のコマを生成して動画としているらしい。
参考:
実際に使ってみると、
- 入力画像からプロンプトを生成し、
- そのプロンプトを元にキーフレームを生成し(デフォルトで8枚; うち1枚は完成形)、
- キーフレームの間を補間するようなフレームを生成し、動画とする。
この3ステップからなる。
2.のステップでキーフレームを生成しているが、ここで失敗すると3.で改善できるわけもなく…。
キーフレームの生成をプロンプトに頼っているので、プロンプトで再現しづらい画像だとうまくいかないっぽい。
というわけで、画像AIで生成しづらい画像を入力すると、キーフレーム生成がうまく行かず、最終的な出力も破綻したものになりがちということがわかった。
そのため、AI生成画像だと比較的安定した出力がしやすいのではないかと思う。
自作の絵のお絵かきタイムラプス風動画の生成がうまくいかなかったのは、そもそもAIによる生成が苦手な類の画像だった可能性があるのと、自分のプロンプティング技術がよわよわな可能性がある。やれたのはキーフレーム生成のseed値ガチャして何度か生成することだけで…。
感想
結局、手描きの絵の作業過程を捏造するみたいな用途には全然使えないっぽいのでうーんという気持ち。AIはいつもそうだ。何もかも自動で生成してくれると思っても、触ってみると思ったより不便で幻滅する。
早く来い来いシンギュラリティ。
